看得见的文件顺序
列表顺序就是输出顺序,适合安排短片头、口播和结束提示。
把短录音按正确顺序合并成一个 WAV,逐个检查衔接后,从浏览器下载完整结果。
在音频工作区选择文件、调整参数并下载结果。音频在浏览器内处理,不需要上传。
文件不会上传。请在离开前下载结果;刷新会清除本地编辑。
每个文件不超过 25 MB,总长度不超过 120 秒,最多八个单声道或双声道录音。浏览器在本地解码,不要求登录。
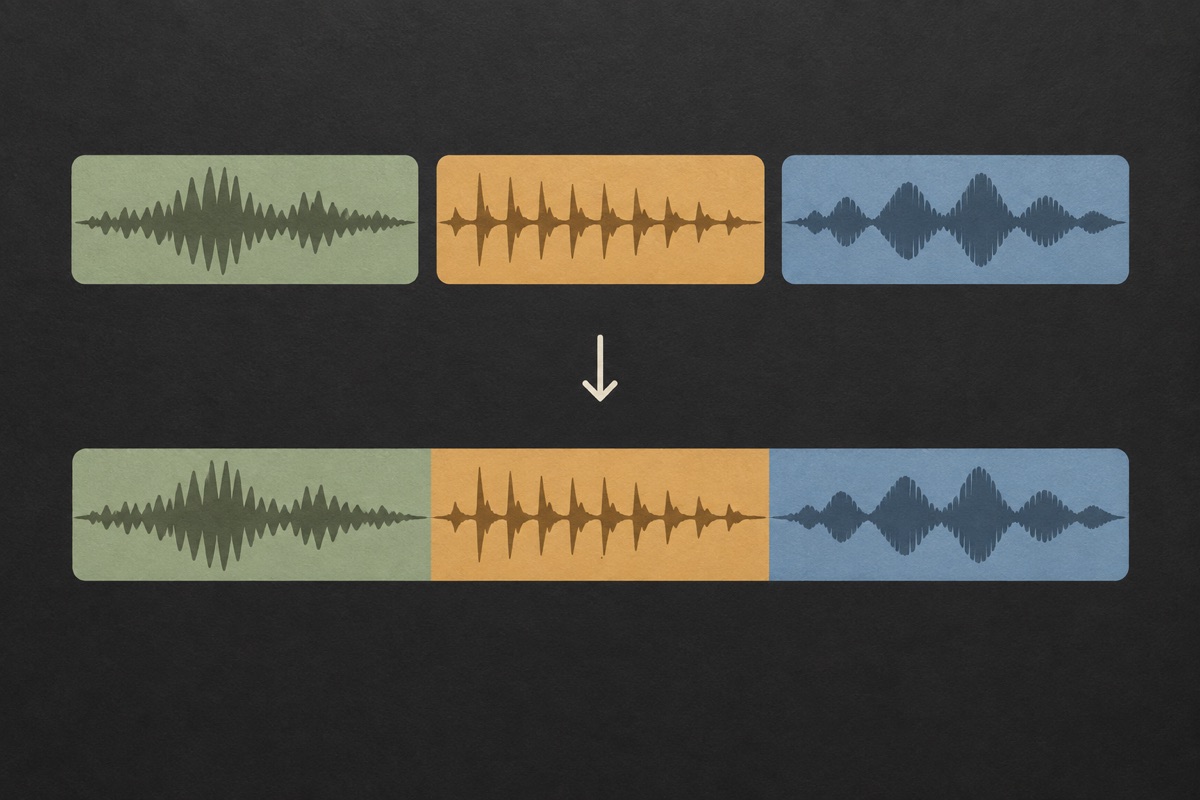
使用上移、下移或移除控件整理文件,核对名称和时长。工具按显示顺序连续播放每个完整片段。
处理并试听合并 WAV,关注静音间隔、音量跳变和顺序。刷新会清空本地序列,离开前下载结果。
列表顺序就是输出顺序,适合安排短片头、口播和结束提示。
合并前转换到 44.1 kHz,需要双声道时把单声道复制到左右通道。
操作在浏览器中完成,不调用付费生成,也不上传到作品库。
接受最多八段、总长 120 秒,不把多轨录音工程伪装成简单拼接。
选择片头、人声和片尾后,结果会依次播放它们,不是让人声与音乐同时发声。需要声音覆盖在背景上时,使用 Agent 的混音流程。先明确是前后衔接,还是同时叠加。
这个区别对播客和台标尤其重要。音乐之后接人声是交接,音乐下方保留人声则是混音。合并器包含整个输入文件,不自动删除静音,需要时先裁剪各个片段。
导入前先确定你要顺序连接还是同时叠加。片头播放完,接着人声,再接片尾,属于顺序;人声说话时背景音乐一直播放,则属于混音。合并工具完成前一种任务,一段结束后下一段开始,不能自动让伴奏铺在人声下面。叠加需求应先到 Agent 混音流程或合适编辑器处理,再按需要连接成品片段。
听一段的结尾和下一段的开头。很响的音乐直接接安静配音,即使拼接正确也可能不舒服。必要时先调整各段音量。工具不自动统一感知响度,也不识别被切掉一半的单词。
不同采样率会转换到 44.1 kHz。任一输入为双声道时输出双声道,单声道复制到两边。这是兼容处理,不是空间音频或高端母带制作。最终文件为 16-bit PCM WAV。
需要交给别人使用时,写清片段顺序以及哪些间隔是故意保留的。如果之后还要编辑,应连同原始片段一起交付。合并文件方便播放,但下载后不再自动带着可单独编辑的片段结构。以后要换一句口播时,从原片段重新组合,比在多次导出后的文件里寻找不确定的边界更稳妥。
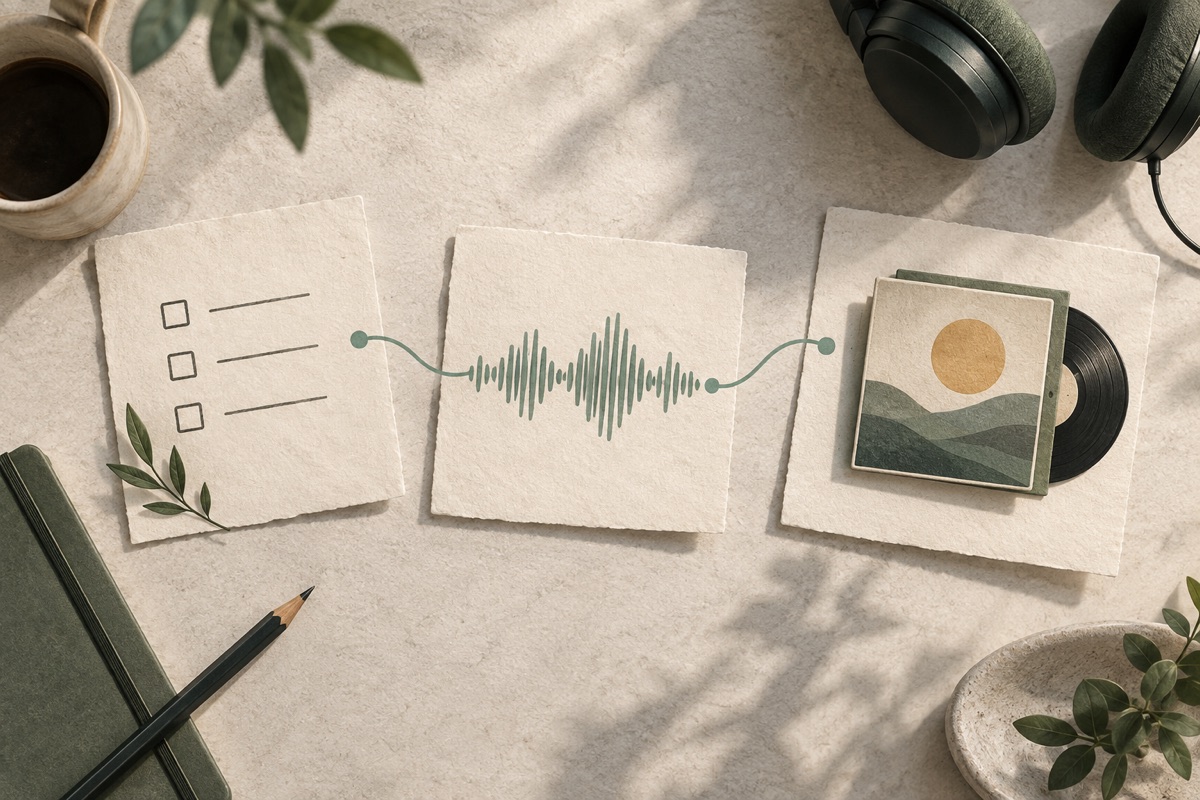
合并 WAV 便于播放,却不再是可拖动片段的录音工程。以后可能更改顺序时,保留每个输入源文件。刷新页面会移除内存序列,不会恢复多轨时间线。
使用有意义的文件名,尤其是多个时长相近的录音。处理后完整听过所有衔接,只检查开头并不能发现错误顺序或结尾重复。源文件不会因为重新排列而被修改。
按顺序安排提示音、台标和结尾。如果声音需要压在音乐上,先混合那部分再拼接。
把几段口播组成一个明确顺序的文件,检查停顿是否自然,避免重复某句话。
只连接有权展示的录音,不把多个例子的串联描述为一段连续原始表演。
浏览器能解码时可以。输入转换为共同采样布局,结果是 WAV,不保留压缩码流,也不输出 MP3。
不会。本版按顺序连接完整片段。可以先加淡入淡出,但这仍然不等于两个音频重叠播放。
这是混音任务。请在 Agent 中上传配音,搭配内置背景。合并器只连续播放文件。
重采样需要落在整数采样位置,显示以秒换算。微小舍入不是忽视实际静音间隔或选错片段的理由。
不会,只从当前序列移除。需要重新处理才会获得新顺序的结果,已下载文件不会自动变化。
本地合并不保存会话。保留源文件和顺序记录,下载结果后再离开。私人 Agent 项目有单独的保存流程。
每个输入最多 25 MB、最长 120 秒,合并后的总长度也必须在 120 秒以内。几段单独合格的文件,加起来仍可能超过限制。如果不影响内容,可以先裁去多余开头、空白或尾音。工具面向短音频和短顺序组合,不用于拼装完整专辑;处理前检查时长,并保留原片段以便调整。
使用文件列表中的排序控件,在合并前排好顺序。处理后特别检查名字、口播和尾音如何连接到下一段。排序不会改写片段内容,也不会自动更新之前下载的结果;调整后要重新导出。给最终文件取容易区分版本的名字,避免合作方误用已经被替换的顺序。
合并只是把文件按顺序连接,不会自动让每段听起来一样响。录音电平、说话者和音乐类型不同,都可能产生明显跳变。先比较来源,再按需要调整音量并重新合并。音量归一可以帮助处理整体 RMS 差异,但不能替代详细混音、压缩或平台要求的 LUFS 检查,最终仍要听实际衔接。
合并前会把解码后的输入整理成一致的输出。单声道与立体声一起使用时,单声道会用于输出的左右两边,但这不等于重新录制了一个真正的立体声来源。检查不同片段的平衡,浏览器解码或准备过程中也可能发生采样率转换。如果后续制作需要保留原声道结构,应同时保留原文件。
从具体文案或有权使用的录音开始,检查实际结果,再决定保留哪个版本。